只改衣服,為什麼連臉和背景都變了?
不知道你有沒有遇過這種情況。
好不容易用 AI 生出一張滿意的圖片,想說:「很好,只差衣服換個顏色。」
改完衣服,發現表情跑掉了。
把表情改回來,背景又變了。
再修一下背景,突然發現——怎麼整張圖看起來像被磨皮過?
原本清楚的髮絲、衣服紋理和小細節,慢慢消失。圖片還是那張圖片的感覺,但就是少了第一次看到時的精緻。
所謂「越算越糊」,到底是怎麼發生的?
這裡說的「越改越糊」,泛指畫質或細節劣化,包含模糊、紋理被替換、顏色偏移或人物外觀改變,不一定是解析度下降。
你以為是在微調,模型可能正在重新畫
用傳統修圖工具調整一個圖層時,我們可以明確控制哪些像素會改變。
但生成式 AI 改圖,可能需要根據原圖和你的指令,重新生成部分甚至較大範圍的內容。你說「只改衣服」,並不代表系統一定會把衣服之外的每個像素原封不動地保留下來。
這也解釋了為什麼修改後,除了想改的地方,人物五官、材質或背景也可能出現差異。OpenAI 的圖像生成文件同樣列出一致性限制:跨次生成時,角色或品牌元素仍可能無法完全一致。圖像生成文件
擴散模型:細節可能在重新生成時改變
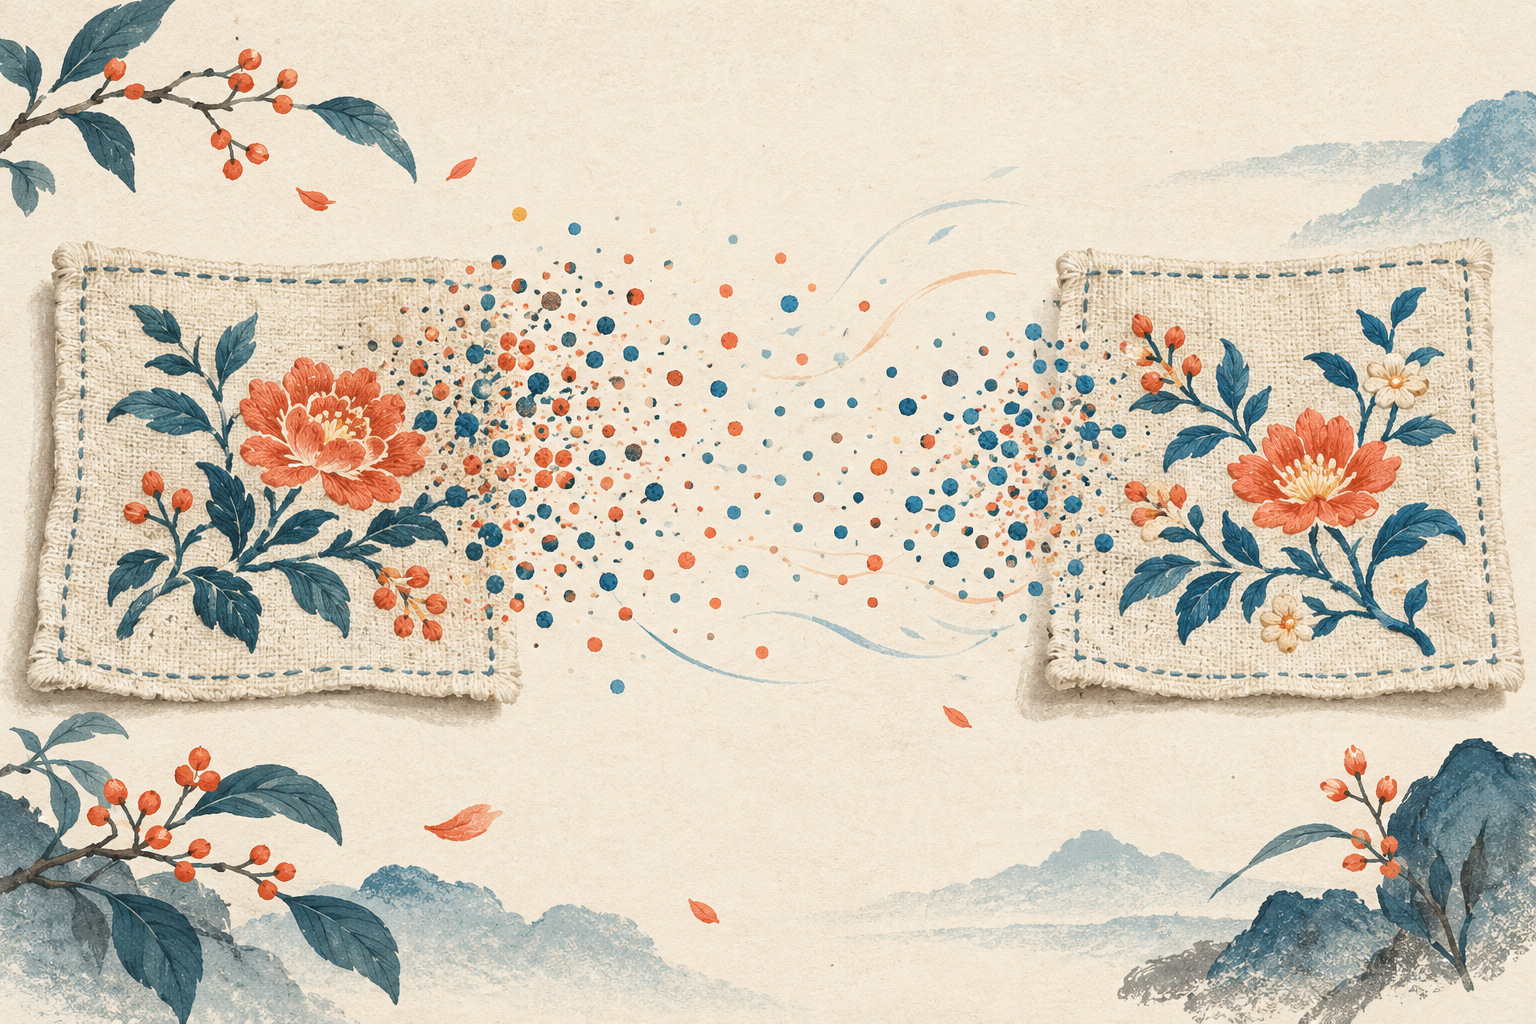
以 SDEdit 這類擴散式編輯方法為例,可以把過程簡單理解成:
原圖 → 加入一定程度的雜訊 → 依照條件逐步去噪 → 得到修改後的圖片。
這裡的「去噪」不是把原本的細節一個個找回來,而是讓模型生成符合條件的內容。
加入的雜訊越多,模型通常有越大的修改空間,但結果也可能越偏離原圖。研究將這種關係描述為「生成影像的真實感與忠於輸入的取捨 」。SDEdit 研究
例如原本衣服上有一段細緻刺繡,重新生成後,模型可能畫出另一段看起來合理的刺繡。遠看都是刺繡,近看卻已經不同。
這是理解擴散式改圖的例子,不能直接當成所有 GPT 圖像模型的內部流程。
為什麼改得越多,細節越容易跑掉?
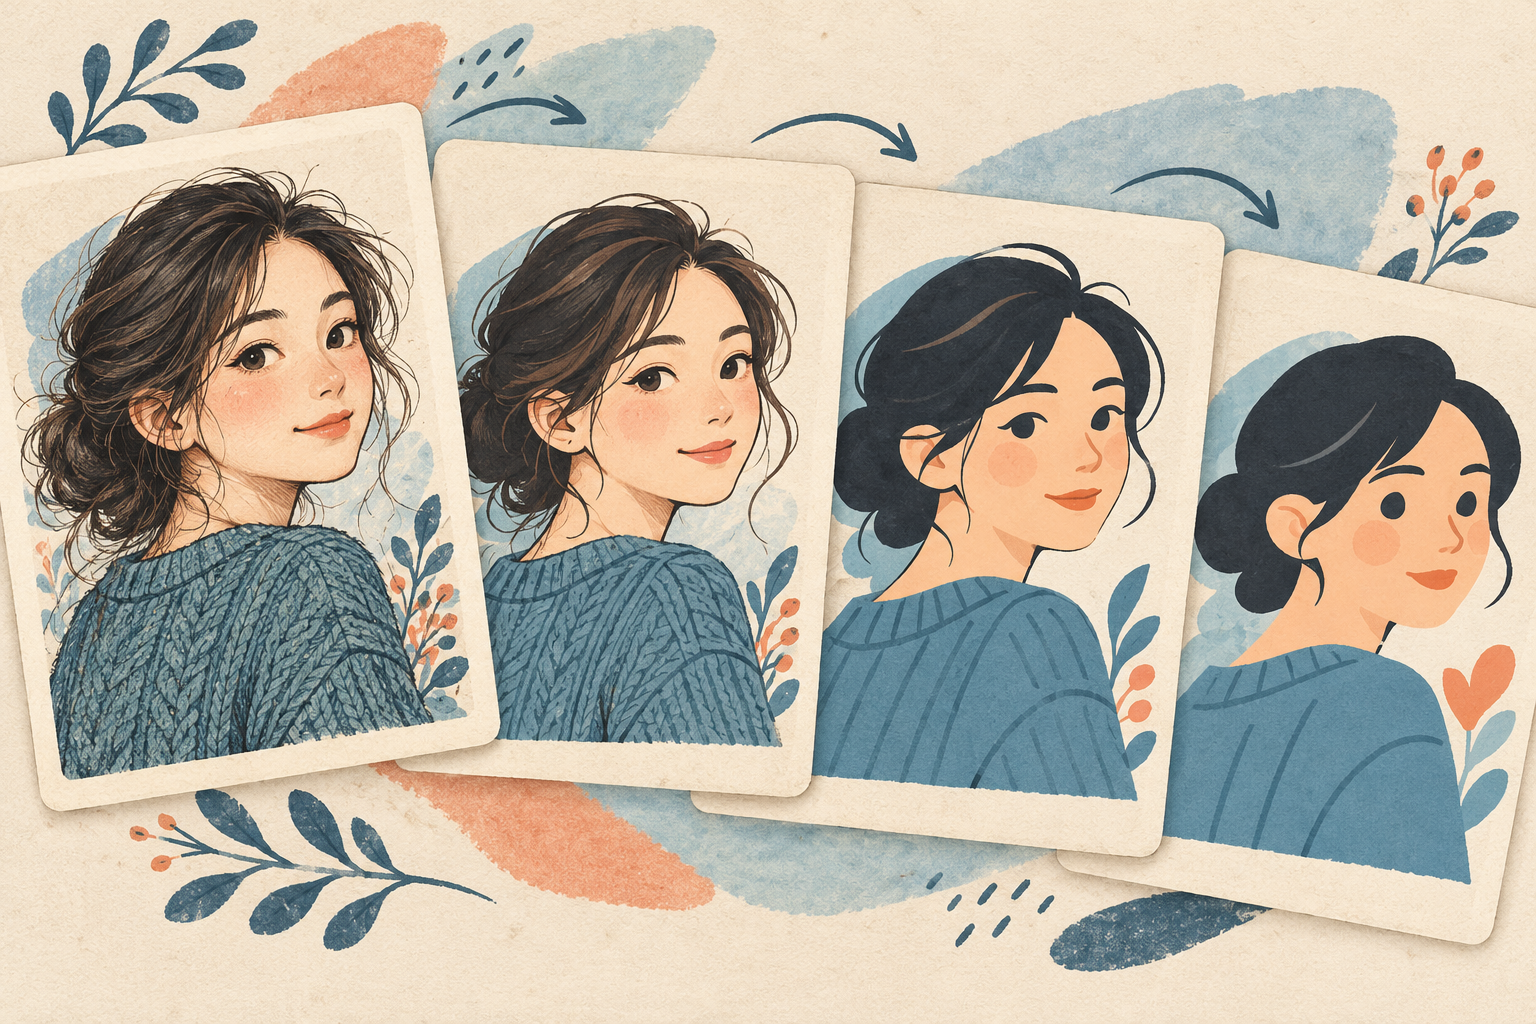
如果每次都拿上一輪的成品繼續修改,上一輪產生的偏差,就可能成為下一輪的起點。
第一次少掉一點布料紋理,第二次髮絲變得比較整齊,第三次臉上的細微陰影又被重新處理。多次累積後,就可能出現我們說的「糊掉了」「塑膠感變重了」或「已經不像原本那張」。
對部分潛在擴散模型來說,還有另一個來源:圖片在像素空間與模型使用的潛在表示之間反覆編碼、解碼,也可能累積失真與雜訊。REED-VAE 研究就專門處理這種多次編輯造成的劣化問題。REED-VAE 研究
上述研究針對特定的潛在擴散流程,不能直接證明 ChatGPT 的內部成因。理解這個問題時,可以先區分「原始細節流失或被替換」與「解析度下降」,再判斷需要調整哪個環節。
這不代表每改一次必定更模糊,也不代表單次生成增加運算步數就會傷害畫質。「同一張圖反覆改」和「一次生成多算幾步」是不同的事。
怎麼減少越改越糊?
我會把改圖流程整理成幾個簡單原則:
- 保留最滿意的原始版本。 改壞了就回到它,不必一直修補已經失真的成品。
- 把相關修改整理後一起提出。 減少來回重畫,但也別一次塞入互相衝突的要求。
- 能局部編輯,就縮小修改範圍。有選取或遮罩功能時善用它,但仍要檢查範圍外是否受到影響。
- 文字、Logo 和精準排版,留到後製處理。 這些元素通常需要更可控的編輯方式。
- 使用原尺寸檔案。 避免拿聊天截圖或縮圖繼續加工,讓解析度損失再疊上來。
下次遇到圖片越改越糊,可以先回頭看看:自己是不是已經拿「修改後的修改版」,又繼續改了好幾輪? 有時候,回到最好的那一張,重新講清楚想改什麼,會比再補一句「幫我變清楚」更有效。
延伸閱讀:AI 影片會不會很假?品牌影片如何避免只有特效、沒有記憶點
如果你正準備把品牌圖片延伸成影片,歡迎提供現有素材與預計用途,與我們討論畫面方向及需要保留的品牌細節。